
文字列処理の安全な書き方
バッファオーバーランは古典的な脆弱性ですが、現在も組み込みシステムの障害要因として報告されています。strcpyやstrcatの危険性は既知の話とされ、代替関数の存在も広く知られています。しかし、strncpyのNUL終端非保証、C11 Annex K(任意規格)のstrcpy_sが利用できない環境、OpenBSD由来のstrlcpyが利用できる環境といった細部では、判断が揺れやすいのが実情です。
この記事ではMITRE CWEの分類、C標準やPOSIXで利用可能な代替関数、JPCERT/CC STR31-CによるNUL終端の設計、MISRA C:2012による予防をたどり、レビュー観点まで落とし込みます。
- strcpy/strcatの何が危険か
- バッファオーバーランで起きる典型的な障害
- C標準の安全な代替(strncpy・C11 Annex Kのstrcpy_s系)
- strlcpy・strlcatの位置づけ
- NUL終端の扱いとバッファサイズ設計
- 静的解析とMISRA C:2012による予防
- コードレビュー時のチェック観点
strcpy/strcatの何が危険か
strcpyはコピー先のサイズを受け取らない関数です。そのため、コピー先に十分な領域が確保されていることを呼び出し側が保証しなければならず、境界計算を誤るとバッファオーバーランを起こし、未定義動作につながる可能性があります。
バッファサイズ未チェックによる書き込み超過
strcpyはコピー元の文字列の長さを確認せず、NUL終端文字(0x00)が現れるまで書き込みを続けます。コピー元の文字列がコピー先のバッファサイズを超えると、コピー先を超える書き込みが起きます。境界チェックの責任が呼び出し側に一任される構造こそが、危険の源です。
CWE-120(Classic Buffer Overflow)の位置づけ
MITRE CWE-120「Buffer Copy without Checking Size of Input ('Classic Buffer Overflow')」は、サイズ確認なしのバッファコピーを代表的な脆弱性として分類しています。
NIST NVD(National Vulnerability Database)を見ると、strcpyやstrcatなどの境界チェックをしない文字列コピー・連結関数の使用に起因するCVE事例が現在も多数報告されています。このことから、これらの関数の使用は、依然として重要な脆弱性要因であることがわかります。
バッファオーバーランで起きる典型的な障害
超えた領域で障害の姿が変わる
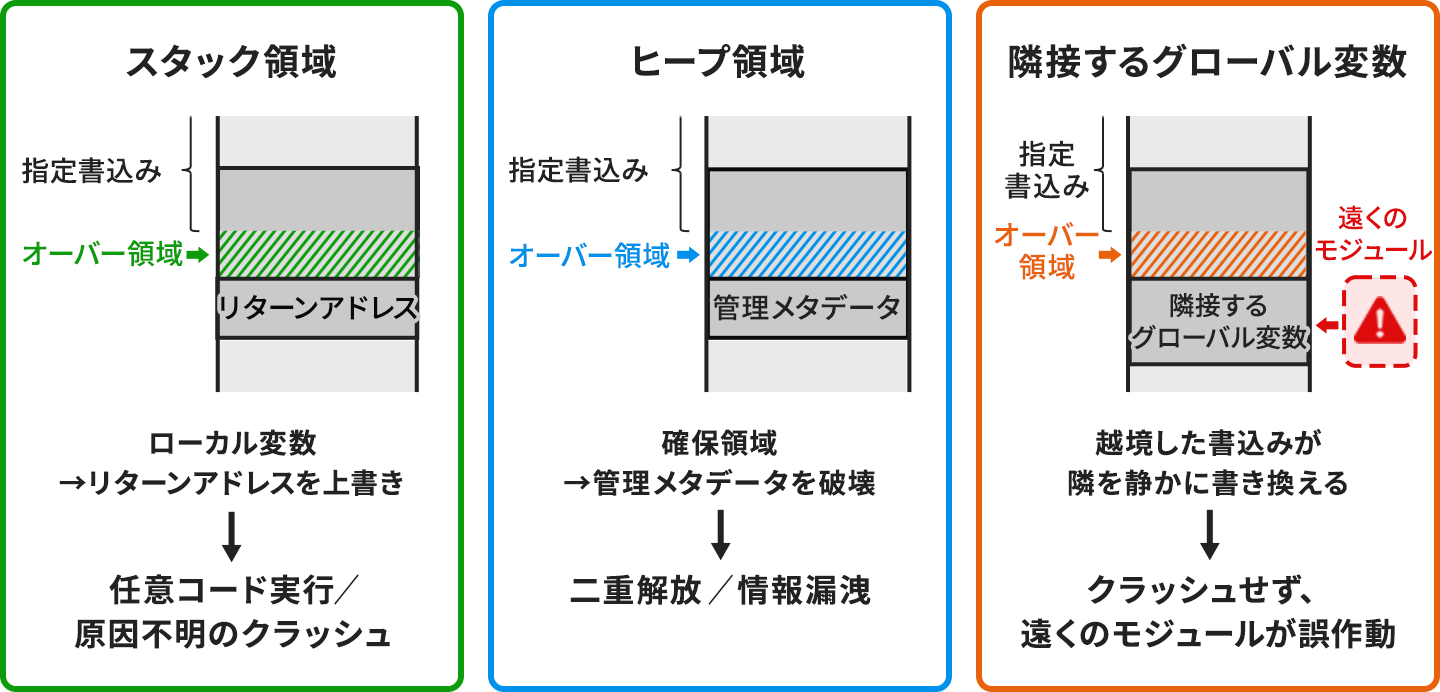
追跡が最も難しいのは、症状が出る場所と原因の場所が離れるとき
書き込み超過そのものは単純な現象ですが、後段で起きる障害は環境ごとに姿を変えます。
スタックベースのバッファオーバーフロー(CWE-121)
「Stack-based Buffer Overflow」に整理されるとおり、スタック上のローカル変数を越えて書き込むとリターンアドレスが上書きされることがあります。攻撃者に制御されれば任意コード実行につながり、そうでなくても不定の場所へジャンプして原因不明のクラッシュを招きます。
ヒープオーバーフロー(CWE-122)
「Heap-based Buffer Overflow」では、ヒープ領域で境界外への書き込みが発生すると、動的に確保したメモリが破壊されます。その結果、プログラムの異常終了や情報漏えい、任意コード実行を招くおそれがあります。
組み込み固有の隣接変数破壊
メモリ構成によっては、越境した書き込みが他のデータ領域へ影響し、グローバル変数や制御用データを破壊することがあります。クラッシュには至らず、遠くのモジュールが誤動作する形で症状が現れるため、追跡が困難な障害の一つです。

C標準の安全な代替(strncpy・C11 Annex Kのstrcpy_s系)
長さ引数を持つ関数への置き換えが第一歩となりますが、置き換え後にも罠があります。
strncpyの落とし穴(NUL終端非保証)
C標準(N1570 §7.24.2.4)の規定にもあるとおり、strncpyはコピー長を制限してくれる一方で、コピー元の文字列長が指定したコピー数以上ならNUL終端文字を書かない仕様です。strlen(src) >= countの場合、destはNUL終端されない(=C文字列として扱うと危険)ため、「制限したから安全」と思い込んで受け取り側でNUL終端文字を前提にすると、次の文字列関数で越境読み出しが起きます。
strncpyは安全コピー関数ではなく、固定長フィールド向けにちょうどNバイトを埋める挙動を持つため、文字列用途では設計上の注意が必要です。
C11 Annex Kのstrcpy_s・strncpy_s
C11規格N1570 Annex K「Bounds-checking interfaces」は、サイズ引数を必須とするstrcpy_s系を規定しており、実行時制約違反(runtime-constraint violation)が発生した場合に、制約ハンドラ(constraint handler)が呼び出されます。実行時制約違反が起きたときは、エラー処理用のハンドラが呼ばれる、といった仕組みです。
ただし、Annex Kのbounds-checking interfacesは任意(optional)の規格であり、実装していないCライブラリも多くあります。glibcでは一般に提供されないため、Linux環境では利用できないことが多いです。
一部のコンパイラ環境のCランタイムライブラリでは早くからこれらの関数群が提供されていますが(Annex Kへの完全準拠ではありません)、移植を前提にするなら環境ごとの提供状況を確認する必要があります。
strlcpy・strlcatの位置づけ
strncpyの弱点を突く形で、OpenBSDが提案したのがstrlcpyとstrlcatです。Todd C. Miller氏とTheo de Raadt氏が1999年のUSENIX Annual Technical Conferenceで発表した論文「strlcpy and strlcat — Consistent, Safe, String Copy and Concatenation」で、その設計思想が示されています。
NUL終端保証と切り詰め結果の返却
同論文では、strlcpyはsize > 0であれば必ずNUL終端文字を書き、コピーしようとした文字列長(strlen(src))を戻り値で返す仕様として設計されました。切り詰めの検知が呼び出し側で明示的におこなえる点が、strncpyとの決定的な違いです。
POSIX(IEEE Std 1003.1)への取り込み
strlcpyとstrlcatはPOSIX.1-2024(The Open Group Base Specifications Issue 8)で標準化され、主要なCライブラリでも順次利用可能になっています。(例)glibc 2.38以降ではライブラリに実装されました。OpenBSDやNetBSDでは古くから実装済みで、POSIXへの採用やライブラリでの提供により利用できる環境は広がっています。
NUL終端の扱いとバッファサイズ設計
代替関数を選んでも、NUL終端の存在を保証する設計は呼び出し側の責任として残ります。
JPCERT/CC STR31-C:十分な領域の確保
JPCERT/CC STR31-C「文字データと null 終端文字を格納するために十分な領域を確保する」は、コピー先バッファに終端文字分の余裕を含めるよう定めています。なお引用中の「null 終端文字」は本文中の「NUL終端文字」と同義であり、ヌルポインタ(NULL)とは別物です。コピーする文字数をsizeof(dst)-1以下に制限し、NUL終端文字を書き込む運用や、strlcpyのような関数を選ぶなど、一貫した方針を決めておくことが重要です。
JPCERT/CC STR30-C:文字列リテラルの扱い
JPCERT/CC STR30-C「文字列リテラルを変更してはならない」では、文字列リテラルへの書き込みを未定義動作と位置づけています。const修飾を徹底し、リテラル領域への書き込みを型システムで弾く構成が実効性を持ちます。
静的解析とMISRA C:2012による予防
静的解析を開発フローに組み込めば、書き手の意識に頼る割合を減らせます。
MISRA C:2012 Directive 4.14(外部入力の検証)
MISRA C:2012 Directive 4.14は、外部から取得したデータの妥当性検証を求めています。UART受信、ネットワーク、ファイルなど信頼境界を越える入力すべてに適用する原則であり、境界チェック漏れの対策として有効です。
静的解析ツールとCI連携
IPA(独立行政法人 情報処理推進機構)「セキュア・プログラミング講座 C言語編」では、静的解析の活用について紹介されています。オープンソースや商用の静的解析ツール(SAST製品)を開発フローに組み込み、危険なAPIの使用やバッファオーバーランにつながる問題を早期に検出する運用が現実解となります。
コードレビュー時のチェック観点
最後に、日々のレビューで拾えるチェック観点を整理します。ツールで検出できない部分は、人の目で補うしかありません。
サイズ引数のあるAPIを選んでいるか
strcpyやstrcatが現れた時点で赤信号であり、strlcpy・snprintf・strcpy_s系のいずれかへの置換が最初の確認観点です。「サイズ引数が正しいバッファのサイズを指しているか」まで踏み込めば、置換後の見落としも減らせます。
信頼境界の明確化
入力元と処理側の境界がどこにあるかを、モジュール図の上で言葉にしておきます。境界の定義が曖昧な実装では、1バイトのズレ(オフバイワンエラー)も重大なバッファオーバーランにつながります。適切な代替関数の選択、バッファサイズとNUL終端の厳格な設計、そして静的解析やレビューによるチェック体制を組み合わせることで、古典的な脆弱性は着実に減らせます。
