
推論モデルの軽量化
機器(端末)側で推論を動かす前提や工程の全体像は、「エッジAI/TinyML入門」で整理しました。学習済みのモデルは、そのままの大きさではマイクロコントローラ(以下、マイコン)に載りません。そこで、まず検討したいのが量子化です。
数値の精度を下げて、モデルサイズと演算コストを同時に削減します。ただし、精度が影響を受ける点には注意が必要です。
この記事では、推論モデルの軽量化に量子化がなぜ効くのか、どの進め方を選ぶのか、精度の落ち方をどう抑えるのかを整理し、最後に推論ライブラリを選ぶときの判断軸まで示します。
軽量化の起点が量子化になる理由
軽量化の手段は複数ありますが、まず検討しやすいのが量子化です。効果を見積もりやすく、学習後量子化の場合は学習をやり直さずに試せるためです。
32ビットの浮動小数点から8ビットの整数へ
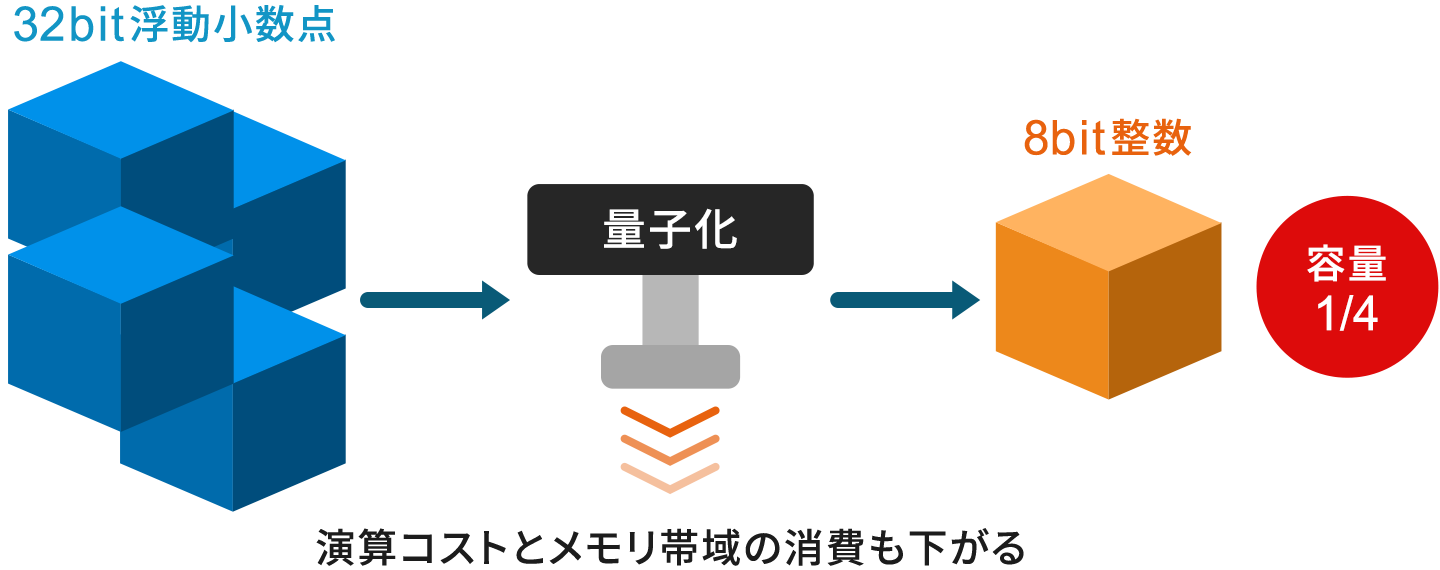
学習済みモデルの重みは、通常32ビットの浮動小数点で表現されています。重みを32ビットの浮動小数点から8ビットの整数へ変換すると、重みが占めるフラッシュ使用量は理論上4分の1になります。実際のモデルサイズ全体の削減率は、バイアス、量子化パラメータ、メタデータなどの割合によって変わります。フラッシュ使用量の制約に直接効くうえ、メモリから読み出すデータ量が減るため、メモリ帯域の消費削減にもつながります。
重みを出力チャネル単位、活性値を層単位で8ビット量子化した場合、幅広いCNNで分類精度の差が浮動小数点モデルに対して2ポイント以内に収まったと報告されています(出典:Krishnamoorthi、2018年)。ただし、これは対象モデルと評価条件に依存します。重みが占める容量が4分の1という削減幅に対して、失うものが比較的小さい点が、量子化をまず試しやすい理由です。
整数の演算だけで推論を完結させる仕組み
量子化は単なる圧縮ではなく、演算の形そのものを変える手法です。量子化では、スケールとゼロ点を用いて実数値を整数値へ対応付けます。スケールは整数の1段階が表す実数値の幅を示し、ゼロ点は実数の0に対応する整数値です。
層の入出力まで量子化形式をそろえることで、浮動小数点演算を使わずに推論を実行できます。一般には、8ビットの入力・重みを用い、積和演算の結果は32ビット整数などのより広い整数型で蓄積し、次の層へ渡す前に再量子化します。
整数演算だけで推論を最後まで実行する量子化方式は、学術論文(出典:Jacob他、2018年)で提案されており、浮動小数点演算器を持たないマイコンでも推論を実行できる、という設計上の意味を持ちます。実数を整数で扱う考え方そのものは、既存記事「FPUなしで高精度な固定小数点演算の設計と実装」で扱ったスケーリングの発想の延長線上にあります。
量子化の2つの進め方
進め方は大きく2つに分かれます。学習をやり直すかどうかが分岐点です。
学習後量子化|再学習なしで整数へ寄せる
学習後量子化(PTQ:Post-Training Quantization)は、学習済みのモデルをそのまま整数へ変換する進め方です。重みと活性値を量子化する一般的なPTQでは、代表的な入力データを用いて各層の活性値の範囲を測定し、スケールやゼロ点を決めるキャリブレーションをおこないます。なお、重みだけを量子化する方式など、キャリブレーションデータを必要としない手法もあります。
Nagel他(2021年)は、8ビットのPTQでは多くの場合、浮動小数点に近い精度を得られると整理しています。ただし、精度低下の大きさはモデル構造、タスク、量子化粒度、キャリブレーション方法に依存するため、1%以内を一律の目安として保証することはできません(出典:Nagel他、2021年)。まず学習後量子化で試し、精度が要件を満たせばそこで完了、という流れが標準的です。
量子化を考慮した学習|低いビット幅でも精度を保つ
学習後量子化で精度が届かないときの選択肢が、量子化を考慮した学習(QAT:Quantization-Aware Training)です。学習の途中に量子化による誤差を織り込み、その誤差ごと吸収するようにモデルを(再)学習させます。
学習データと再学習の時間が必要になるかわりに、8ビット量子化における浮動小数点モデルとの分類精度の差をさらに縮められ、重みを4ビットまで下げるような低ビット量子化にも利用できます。ただし、4ビット形式を効率よく実行できるかは、対象ハードウェアと推論ライブラリが4ビットの格納・演算に対応しているかによります。
手軽さを取るか、精度と圧縮率を取るかというトレードオフであり、学習環境を用意できるかどうかも含めて選ぶことになります。

精度の落ち方を抑える刻み方
同じ8ビットでも、どの単位で刻むかで結果が変わります。ここが実装上の重要な判断点です。
重みはチャネル単位、活性値は層単位で刻む
量子化のスケールをモデル全体で1つにすると、値の範囲が層やチャネルごとに大きく異なる場合に、範囲の狭い部分の分解能が無駄になります。そこで、重みは出力チャネルごとに別々の倍率で刻み、層の途中で生じる活性値は層ごとにまとめて刻む、という組み合わせが広く用いられています。
前述の技術レポート(Krishnamoorthi、2018年)でも、この刻み方が8ビットの学習後量子化で浮動小数点に近い精度を得る前提として示されています。再学習なしでこの水準に届くかどうかは刻み方に大きく左右されるため、使う変換ツールがチャネル単位の量子化に対応しているかは確認しておきたいところです。
感度の高い層だけ精度を残す
モデル全体を一律のビット幅に下げる必要はありません。層ごとに量子化した場合の精度への影響を測ると、誤差に敏感な層とそうでない層があることがわかります。
そこで、影響の大きい層だけ高い精度のまま残し、残りを低いビット幅へ下げる混合精度の進め方が使われています。ただし、効果はモデルと量子化設定に依存するため、対象モデルごとに精度、フラッシュ使用量、RAM使用量、処理時間を評価する必要があります。
全体を一律で下げて精度が崩れたら諦めるのではなく、どの層が精度を支えているかを測ってから配分を決める順序が現実的です。
推論ライブラリを選ぶときの判断軸
ここからは載せる側の話です。製品名で選ぶのではなく、機器の制約に合う条件で絞り込みます。
演算子の対応範囲とメモリ計画の方式
まず確認すべきは次の3点です。
- 使いたいモデルに含まれる演算子が、ライブラリ側ですべて実装されているか
- 実行時に動的なメモリ確保をしない設計になっているか
- 中間データの寿命を考慮して、同じワーキングメモリ領域を使い回すメモリ計画の仕組みがあるか
必要な演算子がライブラリで実装されていなければ、そのままではモデルを実行できません。マイコン向け推論ライブラリでは、アプリケーションがあらかじめ用意した連続メモリ領域(テンソルアリーナなど)を使用し、推論中の動的メモリ確保を避ける設計がよく用いられます。ただし、動的確保の有無や必要メモリの確定時期はライブラリごとに異なるため、採用前に仕様を確認します。
カタログ上の対応モデル数よりも、自社のモデルと機器の制約に合うかどうかを重視すべきです。初期化時にテンソルアリーナサイズが確定する性質を実際のタスク構成へ落とし込む考え方は、既存記事「RTOSのタスク設計」が参考になります。
対応する数値形式で選ぶ
ライブラリが扱える数値形式も判断軸になります。
マイコン向けの推論では、INT8が代表的な形式です。FP16を扱える環境もありますが、FP8の対応状況はハードウェアと推論ライブラリによって大きく異なります。利用可能な数値形式は、対象機器の演算器と推論ライブラリの対応表で確認してください。
ただし、形式の選択肢が多いほど良いとは限りません。低ビット浮動小数点と整数の回路コストは、演算器や累積器の構成、対象ハードウェアによって異なります。特定の回路比較ではFP8のほうがINT8より面積・電力面で不利とする報告もありますが、この結果は一般化できません。数値形式は、対象マイコンまたはAIアクセラレータが効率よく実行できる形式を基準に選びます。
判断の軸は、機器が持つ演算器とライブラリの数値形式が合っているかどうかです。浮動小数点の表現形式そのものは規格で定義されており、詳細は既存記事「浮動小数点の誤差と対策」で扱っています。
最後は自社の機器で測って決める
公開されている比較結果は、特定のモデル、特定の機器、特定の設定という測定条件つきの値です。MLCommons Associationが提供する「MLPerf® Tiny」などの業界標準のベンチマークでは、精度、レイテンシ、エネルギーを評価軸として定めています。ただし、測定範囲、前処理・後処理を含めるか、エネルギー測定の実施条件などはベンチマークの規則に依存するため、数値を比較する際は測定条件を確認します。
自社の機器と自社の入力データで同じ結果が出る保証はありません。判断軸で候補を2つまで絞ったら、同じモデルと同じ入力を両方に載せ、処理時間、RAM使用量、フラッシュ使用量、精度を実測して決めるのが効率的です。そのためにも、何をどの条件で測るかを先に決めるところから着手してみてください。
<参考文献>
- Nagel他「A White Paper on Neural Network Quantization」2021年、arXiv:2106.08295(参照日:2026年9月15日)
- Krishnamoorthi「Quantizing deep convolutional networks for efficient inference: A whitepaper」2018年、arXiv:1806.08342(参照日:2026年9月15日)
- Jacob他「Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference」CVPR 2018(参照日:2026年9月15日)
