
エッジAI/TinyML入門
機器(端末)の中で推論まで完結させたい、という要望が増えています。ただし、マイコンのRAMは数百kB、フラッシュメモリも数MBという規模です。クラウド向けに作られたモデルは、そのままでは載りません。
この記事では、機器側で推論する理由から、資源の制約がどこに効くのか、実機で動かすまでに何を揃えるのかを整理します。読み終えたときに、手元の機器で試すかどうかを判断できるよう、必要な情報を網羅しました。
なぜ推論を機器側で動かすのか
まず、あえて資源の乏しい機器で推論する理由を明確にします。理由が曖昧なまま始めると、後の設計判断が揺らぎます。
遅延と通信量の制約により処理を手元へ寄せる
クラウドに推論を任せる構成では、判定のたびに通信が往復します。ネットワーク状況で遅延が揺らぐため、応答時間を一定にしたい用途では不利です。
センサ値を常時送信する構成では、通信量や送信にかかる消費電力も無視できません。データをクラウドまで運ばず、発生地点の近くで処理する考え方は総務省「令和7年版情報通信白書」(第Ⅱ部第1章第8節3「エッジコンピューティング」)でも整理されており、遅延の影響を低減できる点が利点としてあげられています。
判定結果だけを送る構成にすれば、通信量も大きく減らせます。処理をデータの発生地点へ近づけることで、通信による遅延や通信量を抑えやすくなる、というのが機器側で推論する動機です。
学習はサーバ、推論は機器という分業
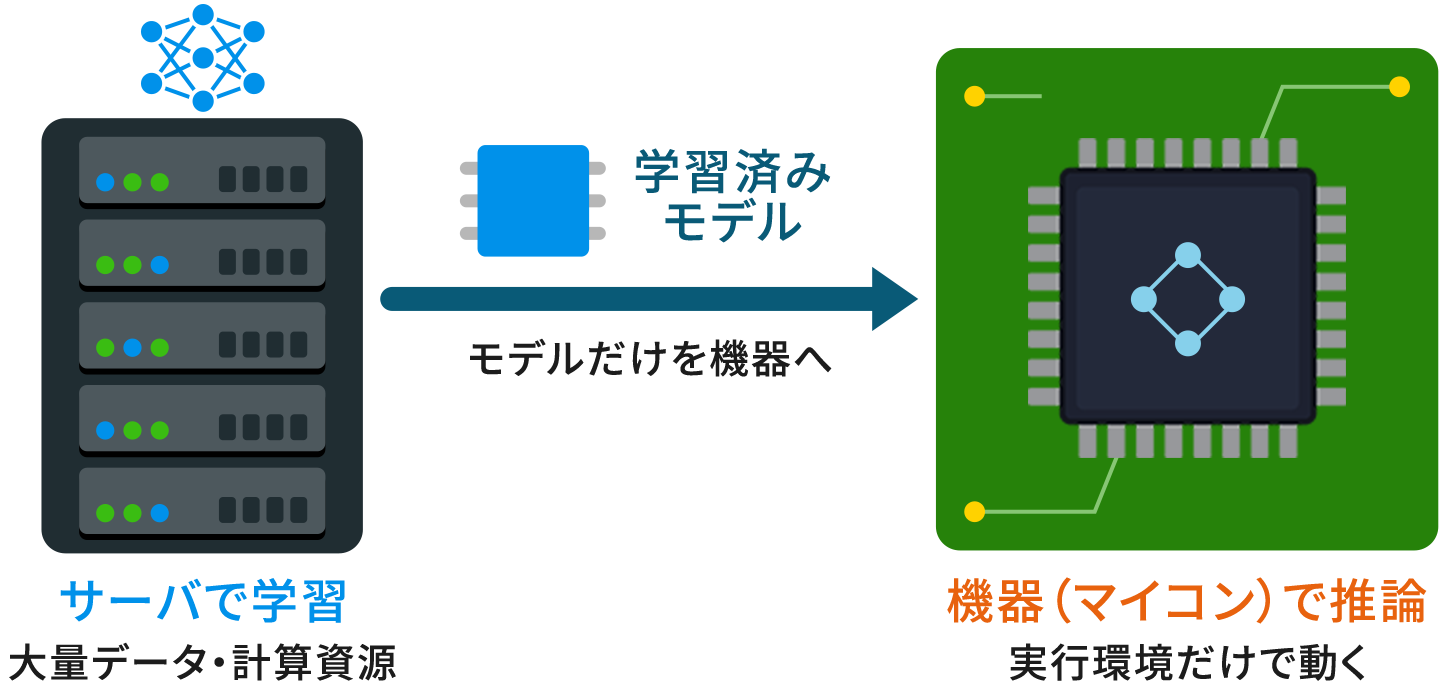
機器側で動かすといっても、必ずしも機器の上で学習まで担うわけではありません。大量のデータと計算資源を使った学習をサーバ側でおこない、機器側はできあがった学習済みモデルを実行する、という分業が一般的です。この分業から設計上の帰結が1つ導けます。
この一般的な分業で、機器側に必要なのは学習の機能ではなく、学習済みモデルを読み込んで実行する推論実行環境だけです。マイコンに求められる役割を推論の実行に限定できるからこそ、数百kB規模の資源でも、モデルと推論実行環境を適切に設計すれば機器側での推論が現実的な選択肢になります。
マイコンの資源が設計を決める
機器側で動かすと決めた瞬間、まず問題になるのはメモリの制約です。ここを飛ばすと、動作しない理由の特定が難しくなります。
RAMは中間データ、フラッシュメモリは重みが占める
メモリの制約は主に2種類に分かれます。RAMは、中間データ(活性化値)に加え、推論実行環境の作業領域、スタック、センサ入力用バッファなどに使われます。特に中間データと推論用メモリアリーナのピーク使用量が、モデルを実行できるかどうかを左右します。フラッシュメモリには、主にモデルの重み、推論実行環境のコード、定数テーブルなどを格納し、その容量がモデルサイズの上限を決めます。
査読論文(出典:Lin他、NeurIPS 2020)では、SRAM 320 kB、フラッシュメモリ1 MBという構成例に対して、クラウド向けの画像分類モデルは容量が100倍規模で超過すると報告されています。モバイル向けとされるモデルでも中間データがピークで22倍を超え、8ビット整数化してもなお5.3倍を超えるとされています。
どちらの制約に引っかかっているのかを分けて把握することが、対策を選ぶ前提になります。容量が超過している場合はモデルの軽量化、中間データが超過している場合は層の構成の見直しと、対策が変わるからです。
動的なメモリ確保を前提にしない
もう1つの制約が、メモリ確保の仕方です。長期稼働する組み込み機器では、実行中のヒープ確保が断片化や確保失敗の原因になるため、動的確保を避ける設計が求められます。
代表的なマイコン向けの推論実行環境には、この前提で設計されているものもあります。査読論文(出典:David他、MLSys 2021)では、原則としてあらかじめ用意した連続領域から初期化時に必要量を確保し、推論中の動的確保を避ける設計が多いことが、断片化によるエラーを避ける狙いとともに述べられています。
推論に必要なメモリ量が初期化時に確定するこの性質は、スタックやタスクの設計と同じ発想で扱えるという意味で、組み込み開発者にとって違和感の少ない考え方といえるでしょう。

推論を動かすまでの3工程
順序を間違えると手戻りが大きくなります。前処理、モデル変換と量子化、実機測定の3つに分けて説明します。
前処理を学習時と実機で一致させる
モデルに入力する前のデータの整え方(たとえば切り出す窓の長さ、標本化の周期、正規化の方法など)が、学習時と実機でずれていると、モデル自体が正しくても精度が低下します。原因の切り分けも難しく、モデルを疑って時間を費やしがちです。
そこで、実機のセンサやメモリの制約で決まる前処理を先に確定し、学習側の前処理も同じ設定に揃える、という順序で進めます。割り込みで取り込んだセンサ値をどう蓄えるかは「割り込み処理とデバッグの基礎」の記事に、センサ値を整数で正確に扱う方法は「FPUなしで高精度な固定小数点演算の設計と実装」「浮動小数点の誤差と対策」の記事に記載されており、この記事に関連する内容です。
モデル変換と量子化で載る大きさにする
前処理が決まったら、学習済みモデルを機器向けの形式へ変換します。ただし、形式の変換だけでは機器に載らないことが多く、32ビット浮動小数点で表現された数値を8ビット整数へ変換する量子化までを含めて1つの工程と考えるのが実態に合っています。
前述の論文でも、8ビット整数化してもなお制限を超える例が報告されているとおり、量子化は出発点であり、量子化だけで容量の問題が解決するとは限りません。量子化の進め方や精度への影響の抑え方は、「推論モデルの軽量化」で詳しく扱います。
実機で処理時間・メモリ・消費エネルギーを測定する
最後の工程は実機での測定です。机上の演算回数はあくまで目安であり、判断の根拠は実機で測定した処理時間、使用メモリ、推論1回当たりのエネルギーに置きます。
MLCommons Associationが提供するベンチマークスイート「MLPerf® Tiny」では、精度(Accuracy/AUC)、レイテンシ(Latency)、推論1回当たりのエネルギー(J/inference)を測定します。ただし、v0.5の測定区間は主にモデル推論であり、前処理・後処理は含まれません。製品としての性能を評価する際は、センサ取得、前処理、後処理、通信を含めたシステム全体の処理時間と消費電力も別途測定します。
演算回数(MACsやFLOPs)は、候補モデルを絞り込む初期段階の参考値にはなります。ただし、実際の処理時間と消費エネルギーは、メモリアクセス、命令セット、クロック周波数、アクセラレータの有無、実装方法などにも左右されます。そのため、最終判断は実機での処理時間、使用メモリ、推論1回当たりのエネルギーを測定しておこないます。
- 出典:Banbury他、「MLPerf Tiny Benchmark」、Proceedings of the Neural Information Processing Systems Track on Datasets and Benchmarks、2021
リアルタイム設計へ組み込む
推論が動作するだけでは製品にはなりません。既存の周期処理の中に組み込んで、はじめて実装となります。
共通の基準で比べてから選ぶ
自社の用途にどの規模のモデルが必要なのかは、業界標準のベンチマークが定める4つの課題が指標になります。
リファレンスモデルのサイズと精度目標は、それぞれ以下のように設定されています(出典:Banbury他、NeurIPS 2021、参照版はMLPerf Tiny v0.5)。
- 音声のキーワード検出は、モデルサイズ52.5 kB、Top-1正解率90%
- 画像から人物の有無を判定する二値分類は、モデルサイズ325 kB、Top-1正解率80%
- 画像分類は96 kB、Top-1正解率85%
- 機械音の異常検知は270 kBでAUC 0.85
自社の用途に近い課題を選び、その規模感を出発点に比較すれば、必要なメモリと達成できる精度の見当を開発着手前に付けられるでしょう。
推論タスクの周期と優先度を決める
推論はモデルによっては実行時間が長くなり、他の周期処理を圧迫する可能性があります。そのまま高い優先度に置くと、制御や通信といった締め切りの厳しい処理の実行を妨げかねません。
基本の配置の一例として、推論を独立したタスクに切り出し、センサ側からの入力をキュー経由で渡す構成が考えられます。推論実行環境のメモリを初期化時に確定させる考え方は、タスクのスタックサイズなどを事前に見積もる組み込み設計とも共通する部分です。既存記事「RTOSのタスク設計」で扱った考え方も参考になるでしょう。
ここまで来れば、あとは実装に着手するだけです。まずはベンチマークの4課題から自社の用途に近いものを1つ選び、実機で処理時間とメモリを測定するところから始めてみてください。
