
競合状態とアトミック性
同じ変数を複数の実行文脈(コンテキスト)が同時に操作すると、読み書きの順序次第で結果が変わることがあります。これは組み込み開発で再現の難しい不具合のおもな原因の一つです。
この記事では用語を次のとおり使い分けます。同期なしの同時アクセス(少なくとも一方が書き込み)をデータ競合、それにより振る舞いが変わる現象を競合状態と呼びます。主に「共有変数のデータ競合」が原因で起きる競合状態を扱います。なおC11以降、データ競合は未定義動作となるため、再現性の有無に関係なく避けるべきものとして扱います。
アトミック性が破れる | read-modify-write の3段分割
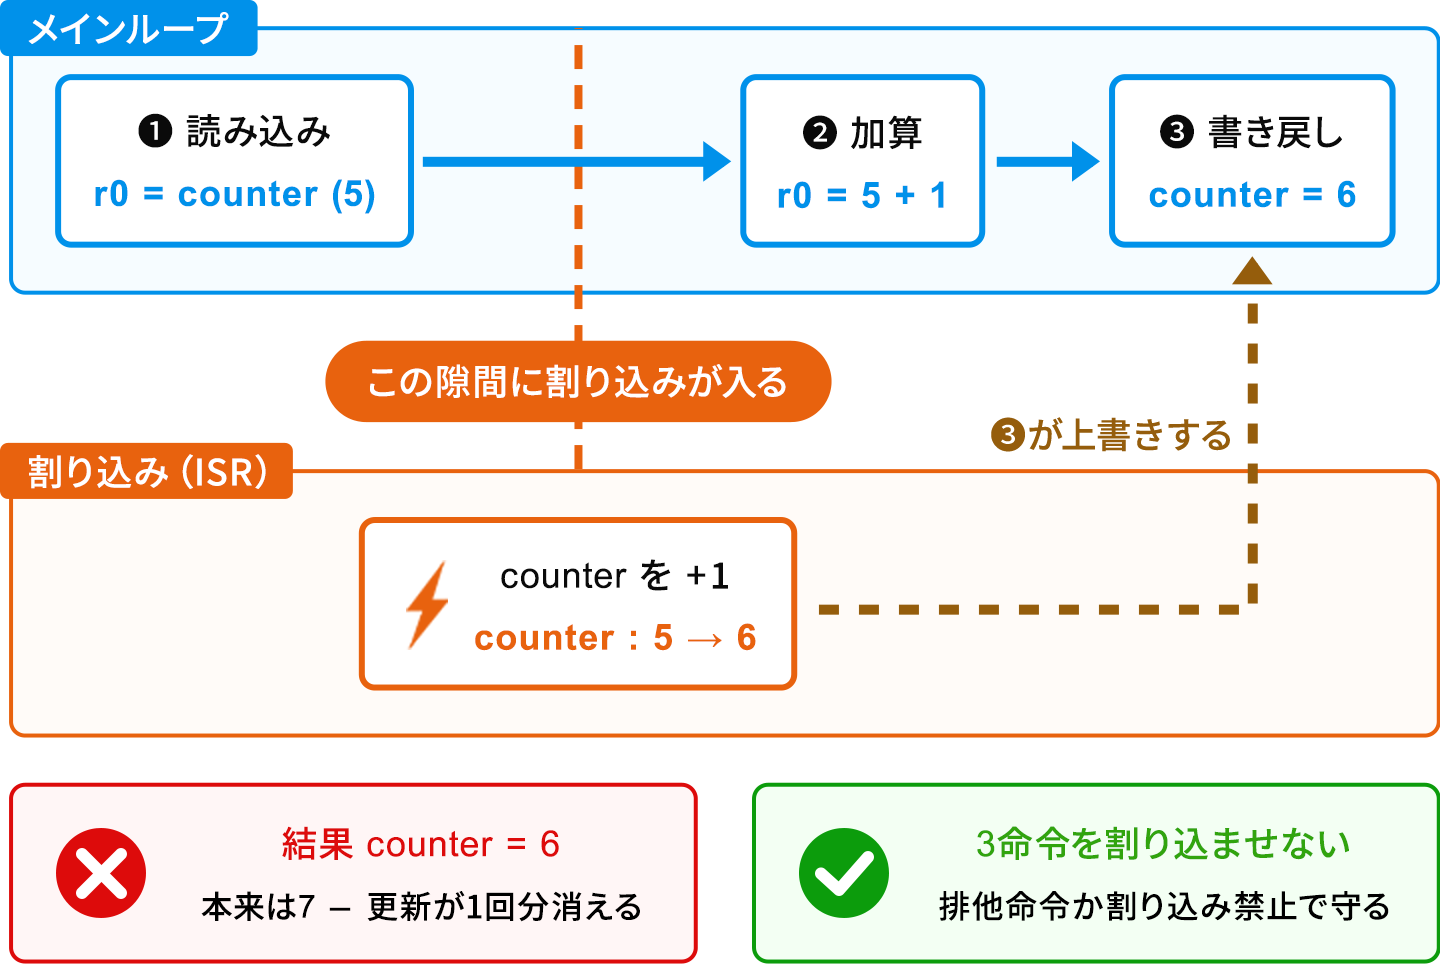
counter++ → 3命令に分かれる
C言語にはC11以降アトミック型が用意されていますが、組み込み向けのコンパイラでは未対応の場合もあります。実務では、実装による工夫も必要です。
この記事では競合状態やアトミック性が損なわれる代表的なパターンを示したのち、C言語での実装方法やポイントを解説します。
- 競合状態とは|複数の実行文脈が同じ変数にアクセスする問題
- アトミック性が破れる代表パターン
- C言語で使える排他とアトミック操作
- Cortex-Mでの実装|LDREX/STREXとメモリバリア
- 共有変数の不具合の見つけ方
- 設計時に押さえる原則
競合状態とは|複数の実行文脈が同じ変数にアクセスする問題
複数のスレッドが同じ変数を同時に読み書きすると、負荷やクロック、コンパイラの最適化でタイミングが変わるため、同じコードでも正常に見えたり、まれに誤動作(値化け・取りこぼし・ハング)したりします。組み込みシステムでは、競合状態が不具合の原因になりがちです。
割り込み・タスク・DMAの3方向から起こる
メインループとISR(割り込みハンドラ)、RTOS(Real-Time Operating System:リアルタイムOS)の複数タスク、DMAとCPUなど、組み込みシステムでは競合の起こる経路がいくつも重なって存在します。ベアメタル組み込みシステムで典型的な例に、ISRとメインループが同じ変数を共有する形があげられます。センサ値をISRが書き、メインループが読み取るだけの構成でも、読み出しの途中で更新が入ると意図しない値を取ることがあります。
再現しない不具合の多くはここに原因がある
競合状態はタイミングが合ったときだけ現れるため、量産の直前や実機ではじめて発覚することがよくあります。個々のコードは単体では正しく動くのに、同時に実行したときだけ症状が出るため、切り分けにも修正にも手間がかかります。最初から共有変数を重点的に確認すると、発見までの時間を縮められる可能性があります。
アトミック性が破れる代表パターン
アトミック性(原子性)とは、操作が途中で中断されずに最後まで完了する性質を指します。状態は「完全に終わっている」「始まっていない」のどちらかしかありません。この性質が破れやすい、組み込みでよくあるケースを2つあげます。
read-modify-writeの3段分割で他文脈が割り込む
counter++の一行も、機械語では読み込み、加算、書き戻しの3命令に分かれます。この途中で別の文脈が同じcounterを書き換えると、あとから書き戻した値が先の更新を上書きし、更新が1回分消えてしまいます。8ビットのマイコンで32ビットの変数を扱うときは、その読み書きが複数の機械語命令に分割されるため、更新途中の値を読み取られるリスクが増します。
ビットフィールドの隣接メンバが同じ語に載る
JPCERT/CCのCON32-Cが指摘するとおり、隣り合うビットフィールドは同じメモリ位置に同居することがあります。この場合、片方のビットを更新する処理も、内部ではその語全体を読んで書き戻します。あるビットの修正中に別の文脈が隣のビットを書き換えると、元の修正内容が消えてしまうおそれがあります。

C言語で使える排他とアトミック操作
共有変数をatomic_intのように宣言すると、規格上はアトミック操作として扱われ、データ競合の回避に使えます。ただしロックフリー性や性能は処理系依存です。順序の強さはmemory_orderで指定でき、acquire/releaseなど必要な保証に応じて選べます。標準の枠組みで競合を防げるため、対応している環境ではまず標準アトミックを検討します。
C11 <stdatomic.h>のatomic_intとmemory_order
atomic_intとmemory_orderはC11(ISO C)で定義されており、atomic_load_explicitやatomic_store_explicit、atomic_fetch_add_explicitを使用します。
厳しい順序ほど安全ですが最適化は効きにくくなるため、必要な保証に見合う強さを選びます。
__STDC_NO_ATOMICS__で未対応環境を見分ける
<stdatomic.h>はオプション扱いで、組み込みのコンパイラでは未対応の場合があります。規格上、__STDC_NO_ATOMICS__を定義する実装はこのヘッダも機能も持たなくてよいと決められています。__STDC_VERSION__が201112L以上かつこのマクロが未定義のときだけ標準アトミックを使います。そうでない場合は割り込み禁止などの代替へ切り換えると、環境をまたいで安全に書けます。そのため、ビルド時にはヘッダの有無も含めて確認します。__has_includeによる存在確認や、ビルド設定での明示があると安全です。
Cortex-Mでの実装|LDREX/STREXとメモリバリア
この記事では、代表的な32ビットマイコンアーキテクチャとしてArm Cortex-Mを例に説明します。Cortex-M3以降のマイコンには、排他アクセスの命令(LDREX/STREX)がCPU側に用意されています。メモリバリアの命令(DMB)はCortex-M0/M0+でも利用できます。LDREX/STREXを適切に用いることで、ロックを取らずに共有データをアトミックに更新できます。他のアーキテクチャでは、同等のアトミック命令や割り込みマスクによって同じ仕組みを実現します。
LDREX/STREXで排他アクセスを実現する
対応するコンパイラの組み込み関数(intrinsic)、またはCMSIS-Core(Arm提供)の__LDREXW/__STREXWで、32ビットワードの排他ロードと条件付きストアを実行します。LDREXで読んだ値を更新し、STREXで書き戻す間に、他の実行文脈から同一アドレスへのアクセス、または排他状態を破る要因があると、ストアが失敗してリトライが必要になります。割り込みやコンテキストスイッチ、マルチコア環境での別コアからの書き込みが、その要因に当たります。
失敗した際にやり直すことで、安全なread-modify-writeを作れます。Cortex-M0/M0+は、LDREX/STREX(排他アクセス命令)を持ちません。そのためread-modify-writeの保護は、__disable_irq()による割り込み禁止などで置き換えます。
DMB/DSB/ISBを必要な位置に挿入する
アーキテクチャリファレンスマニュアルが示すように、DMBはメモリアクセスの順序(ordering)を制約します。DSBは、先行するメモリアクセスがすべて完了するまで後続の命令を実行させません(completion/synchronization)。ISBは以降の命令実行に対しパイプラインを同期し、設定変更の影響を反映させます。割り込みコントローラの設定を変えた直後など、順序が入れ替わると困る箇所に挟みます。
普段は不要でも、割り込み設定やスリープまわりでは、これらのバリア命令がないと設定の反映を待たずに意図しない動作をすることがあります。
共有変数の不具合の見つけ方
静的解析と動的解析を組み合わせるのが、現場での落としどころになります。静的解析は全経路を調べて実装前に問題を発見できる反面、誤検出を起こしやすい傾向があります。一方、動的解析は実運用に近い挙動を観測できますが、実行時の負荷がかかります。
静的解析|JPCERT/CC CON32-C / CON35-Cを活用する
JPCERT/CCでは、隣接データの競合を防ぐ「CON32-C」や、デッドロックを防ぐ「CON35-C」をルールとして提示しています。静的解析ツールが対応している場合は、該当するチェックルールを有効にします。
コーディング規約に組み込んでおけば、疑わしい箇所を実装前に洗い出せます。早い段階で修正すれば、後工程での手戻りが減ります。
動的解析|負荷試験とスタック比較で異常値を追い込む
長時間の負荷試験で想定外の値が出たら、共有変数の競合を原因の一つとして疑います。競合は状況によって発生する場合としない場合があるため、タイミングを揺さぶるストレステストで表面化しやすくなります。あわせてスタックオーバーフローが起きていないか、過去の事例やスタックの最大使用量も確認して切り分けます。
設計時に押さえる原則
共有変数を扱う設計そのものを見直すことが、競合を防ぐ根本的な対策です。共有データを保護する仕組みを追加するより、共有するデータ自体を減らすほうが、競合のリスクを下げる方法として有効です。
共有変数はvolatile宣言だけでは不十分
volatileはコンパイラによる最適化を抑え、メモリアクセスを書いたとおりにおこなわせる指定です。ISRと共有する変数を予測どおりに読ませるには役立ちます。ただし、volatileは可視性の一部(コンパイラの最適化の抑止)に関係するだけで、アトミック性や排他・順序・複数CPU間の同期の代替にはなりません。
複数の命令により更新される変数を守るには、C11のアトミック型か、Cortex-Mの排他命令、あるいは割り込み禁止を用います。
共有区間を最小化しキュー経由の受け渡しに置き換える
変数の直接参照をキュー経由の受け渡しに切り換えると、データをコピーして渡す方式などにより、複数の実行文脈から同じ変数を直接操作する必要がなくなります。結果として、競合そのものが起こりにくくなります。設計の段階でこの形を選んでおくと、事後の検証が楽になります。
