
マルチコア組み込みの設計
CPUコアが2つになれば処理は2倍速くなる、とは限りません。コアは増えても、メインメモリや下位階層の共有キャッシュ、周辺回路は共有されたままである点に注意が必要です。共有資源の奪い合いが起これば、実行時間の増加につながる可能性があります。また単一コアでは成立していた排他制御も、複数のCPUコアを搭載する「マルチコア」では不十分になるおそれがあります。
この記事では、マルチコアで変わる点を整理します。そのうえでAMPとSMPの選び分け、コアをまたぐ排他制御の落とし穴、コア間でデータを受け渡す方式の使い分け、干渉を実際に測定する方法までを扱います。
なお、この記事では実行単位(例:RTOSのタスク、OSスレッド)を「処理」と呼びます。
コアを増やしても実行時間は比例して短くならない
まずは性能の話から入ります。「CPUコアを増やせば実行時間を短縮できる」と単純に考えたまま移行すると、処理がデッドラインに間に合わなくなるおそれがあることに注意してください。
共有する資源の奪い合いが実行時間を延ばす
異なるコアで動くソフトウェアの間に明示的なデータの受け渡しがなくても、実行時間に影響をおよぼす可能性があります。共有メモリへのアクセスが競合して待ち時間が生じることや、共有キャッシュで一方が他方の内容を追い出してキャッシュミスが繰り返されることなどが、その一例です。
認証当局で構成されるCAST(Certification Authorities Software Team)が公表した文書CAST-32A(2016年)は、こうした影響が最悪実行時間(WCET:Worst-Case Execution Time)の増加を引き起こしうると明記しています。なお、その考え方は後述のAMC 20-193へ引き継がれています。
単一コアで実測した実行時間は、他のコアによる影響を受けない場合の値にすぎないと捉え直すことが必要です。
干渉の経路を洗い出してから設計に入る
航空分野の指針はこうした影響を「干渉」と呼んでいます。干渉を引き起こしうるプラットフォームの性質を干渉経路として定義したうえで、その識別と緩和策の検証を設計者に求めています。
注目したいのは手順の順序です。不具合が出てから測定するのではなく、共有メモリ、共有キャッシュ、バス、周辺回路といった共有資源を設計段階で列挙し、経路ごとに緩和策を対応づけてから実装に入ります。一般の機器開発にも活用できる進め方です。
AMPとSMPの違いと選び方
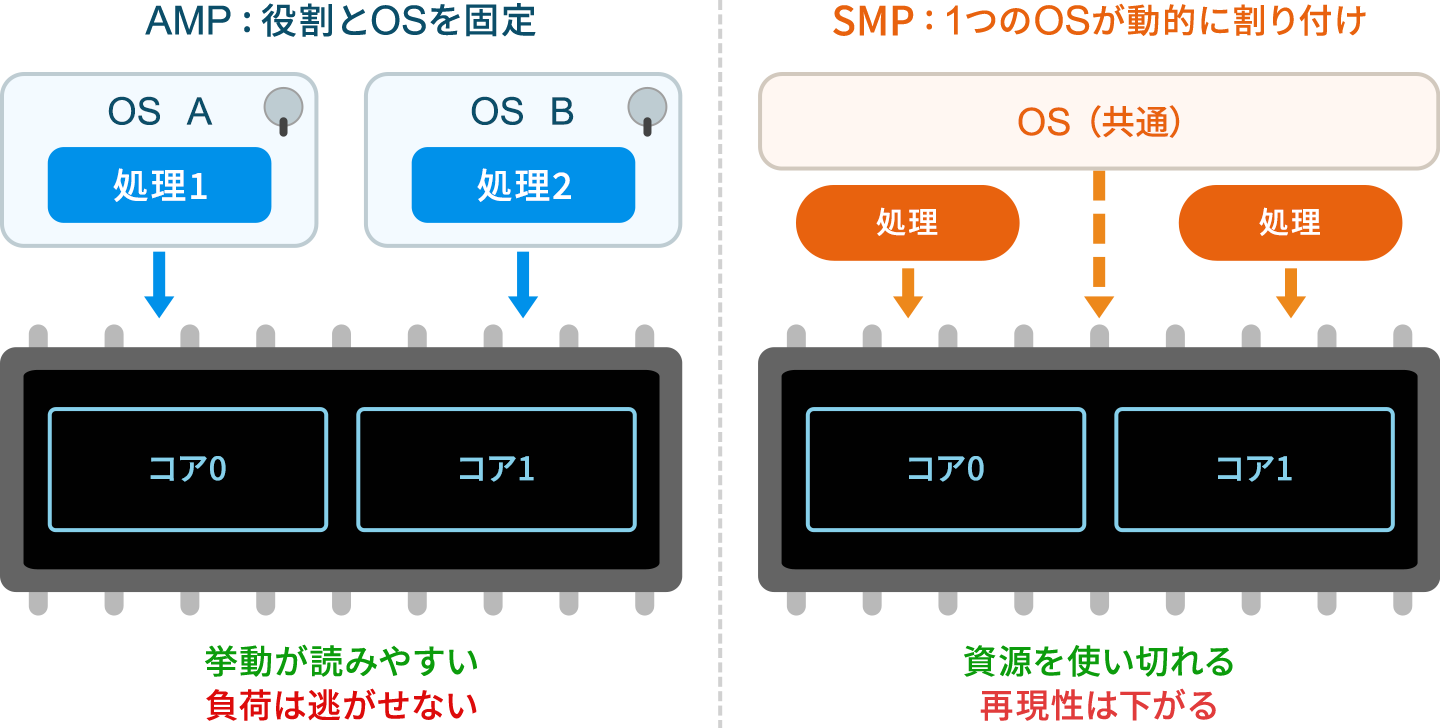
マルチコアの構成方式は、大きく「AMP」と「SMP」に分かれます。実務では中間の形も使われます。判断軸は、リアルタイム性を優先するか、スループットや資源の有効活用を取るかです。どの処理をどう切り出すかについては、既存記事「RTOSのタスク設計」で扱ったタスク分割の考え方がそのまま土台になります。
AMP:コアごとに役割とOSを分ける
非対称型マルチプロセッシング(AMP:Asymmetric Multiprocessing)は、コアごとに別のOSまたは同じOSの別の実体を動かし、処理の割り付けを固定する構成です。制御はこのコア、通信はこのコアというように役割を分ける使い方が典型的です。性能の異なるコアを混載したマイコンとも相性がよいとされています。
挙動が読みやすい一方、特定のコアに負荷が集中した場合でも他のコアに逃がしにくいことに注意が必要です。コア間のデータの受け渡しには、通信の仕組みを設計する必要があります。
SMP:1つのOSがすべてのコアへ割り付ける
対称型マルチプロセッシング(SMP:Symmetric Multiprocessing)は、1つのOSがすべてのコアを管理し、実行可能な処理を空いているコアへ動的に割り付ける構成です。負荷の偏りをOSが吸収するため計算資源を有効活用しやすい反面、どの処理がどのコアで動くかは実行のたびに変わることが前提になります。
たとえば、同じ入力を与えた場合でも、実行順序や割り付けられるコアが変わるケースは少なくありません。このため、挙動の再現が難しくなり、共有データへ同時にアクセスする機会も増えます。実行時間の要求が厳しい処理を抱えるシステムでは、こうした挙動の予測しにくさが課題です。
割り付けを固定する中間の形
実務では、AMPとSMPの特性を組み合わせた構成も用いられます。判断では、厳しいリアルタイム性や再現性を優先する処理と、スループットや計算資源の利用効率を優先する処理を分けて検討します。実行時間の要求が厳しい処理は特定のコアに固定し、残りを動的な割り付けに任せる組み合わせは、その一例です。
欧州航空安全庁(EASA)のAMC 20-193でも、動的な割り付けは決定的な挙動につながる実証済みの制限に基づいて正当化しうるという考え方が示されています。挙動の再現性を重視したい処理がある場合、割り付けの固定は有力な選択肢です。

コアをまたぐ排他制御の落とし穴
マルチコアでは、排他制御の書き方が単一コアの場合と異なります。書き方を誤ればデータ競合の原因となり、未定義動作などの不都合な事態に直結するおそれがあります。
割り込みの禁止は他のコアには作用しない
単一コアでは、「同一コア内の割り込みによる競合」に対しては割り込み禁止が排他として機能します(ただし、DMAなど他のバスマスタは別途考慮が必要です)。一方で、複数コアではこの前提が崩れます。止まるのは自分のコアに対する割り込みだけであり、別のコアは割り込み禁止の影響を受けないため動作し続け、同じメモリ領域へ書き込めるからです。
既存記事「割り込み処理とデバッグの基礎」で扱った作法は、割り込みを禁止したコア自身には有効です。しかし、コアをまたぐ排他制御をするには、単に割り込みを禁止しただけでは不十分です。
複数のコアから同時アクセスしないようにするには、ハードウェアが提供するアトミック命令やハードウェアスピンロックを用いたコア間ロック、またはOSがコア間やプロセス間の共有を明示的にサポートする同期機構を使用します。AMPで別OSが動作する構成では、各OS内だけで有効な通常のミューテックスではコア間排他を実現できない場合があるため、対象プラットフォームの共有メモリ、キャッシュ整合性、アトミック操作の仕様を確認する必要があります。
ただし、複数のロックを扱う場合は、取得順をすべての処理で統一する、タイムアウト付きの取得を用いるなど、デッドロックを避ける設計が必要です。
volatileは同期の手段にならない
volatileを付ければ共有変数は安全になる、という認識も見直しが必要です。情報処理推進機構(IPA)の「組込みソフトウェア開発向け コーディング作法ガイド[C言語版]ESCR Ver.3.0」は、volatile修飾をコンパイラの最適化を抑制する場合に使用するものと位置づけ、アクセスを実行コードでどう構成するかは処理系定義だと述べています。
volatileは主にメモリマップドI/Oレジスタのように、プログラムの通常の処理だけでは値が変化しないとコンパイラが仮定できないオブジェクトへのアクセスで用います。volatileだけでは、複数コアや複数スレッド間で必要となる原子性、メモリ順序、同期、可視性は保証されません。
C11(ISO C)では、異なるスレッドによる競合するアクセス(一方が同じメモリ位置を変更するもの)のうち、少なくとも一方がアトミックでなく、順序関係も定まらない場合をデータ競合とし、その結果を未定義動作と定めています。volatileはこのデータ競合の解消にはつながりません。
メモリのアクセス順序を明示してはじめて成立する
マルチコアでは、あるコアが書いた順序どおりに別のコアが観測するとは限らないため、順序の保証を明示することが必要です。代表的な手段は2つあります。1つはC11以降の言語規格が定めるアトミック型とmemory_orderを使う方法です。なお、アトミック機能は処理系によって未提供の場合があり、利用可否の確認が必要です。
もう1つは対象OSが提供する同期機構を使う方法です。ただし、同期によるメモリ順序の保証範囲はOSおよび同期機構の仕様に依存します。同一プロセス内のスレッド間だけを対象とするもの、共有メモリを使うプロセス間通信にも対応するもの、別OSが動作するAMP構成には使用できないものがあるため、適用範囲を確認します。
IEEE Std 1003.1(POSIX.1)は、複数の実行主体が同じメモリ位置へアクセスする場合の制限、およびメモリを同期する関数を定めています。これらの関数で守られた区間であれば、順序の保証を関数側に任せられる仕様です。メモリアクセス順序を指示する命令を使う際は、どの操作間の順序を保証したいのかを先に決め、その保証を表現する手段を選ぶという順番で考えます。
コア間の受け渡しと検証
最後は、実装の形と検証方法です。排他制御が必要な箇所を減らせれば、ここまでにあげた問題が生じる余地も小さくなります。
なお、排他制御を使う以上、優先度の設計次第では単一コアと同じく優先度逆転も起こりえます。その再現と対策は既存記事「優先度逆転を『再現→検出→対策』まで」を参照してください。
共有メモリとメッセージの使い分け
コア間の受け渡しは、共有領域を双方が直接読み書きする方式と、キューを介してメッセージとして渡す方式に大別できます。
共有メモリ方式は転送の手間が小さいかわりに、アクセス対象の箇所で排他制御と順序の管理が必要になり、守るべき区間がコード全体へ散らばる点が課題です。メッセージ方式では排他制御をキュー操作に集約しやすく、共有データを直接読み書きする方式よりも同期箇所を限定しやすい利点があります。
ただし、キューやメッセージ本体を共有メモリに置く場合、ハードウェアのキャッシュ整合性機能の有無に応じて、キャッシュメンテナンスやメモリバリアが必要です。
組込みマルチコアコンソーシアムの解説記事(※)では、排他制御が想定どおりに動作しないことが不具合の要因になりやすいとしています。そのため、排他制御の箇所を減らす設計はトラブルを未然に防ぐ有効なアプローチとなります。キャッシュ整合性の実務は、既存記事「DMA転送の実務とキャッシュ整合性」を参照してください。
- 出典:第12回 マルチコアで動作するソフトウェアとは|組込みマルチコアコンソーシアム
干渉を意図的に作って測定する
設計を終えたら、想定しうる最悪の条件を自分で作って確認します。対象の処理を動かしながら、別のコアで共有メモリやバスに負荷をかけ続け、実行時間がどこまで延びるかを測定する検証です。
前述の組込みマルチコアコンソーシアムの「EMCマルチコア適用ガイドv1.1」では、マルチコアではテストや不具合事象の再現性が悪く、ステップ実行やブレークポイントを使ったデバッグも難しいと指摘しています。再現性の低い環境で偶然に任せるよりも、干渉という悪い条件を意図的に作って耐性を測定するほうが検証を進めやすくなります。
まずは、設計時に列挙した干渉経路から共有資源を1つ選びます。対象タスクを実行しながら、別コアでメモリ帯域、共有キャッシュ、バス、DMAなどに負荷を与え、対象の処理の平均実行時間、最大実行時間、ジッタがどの程度増加するかを測定します。
